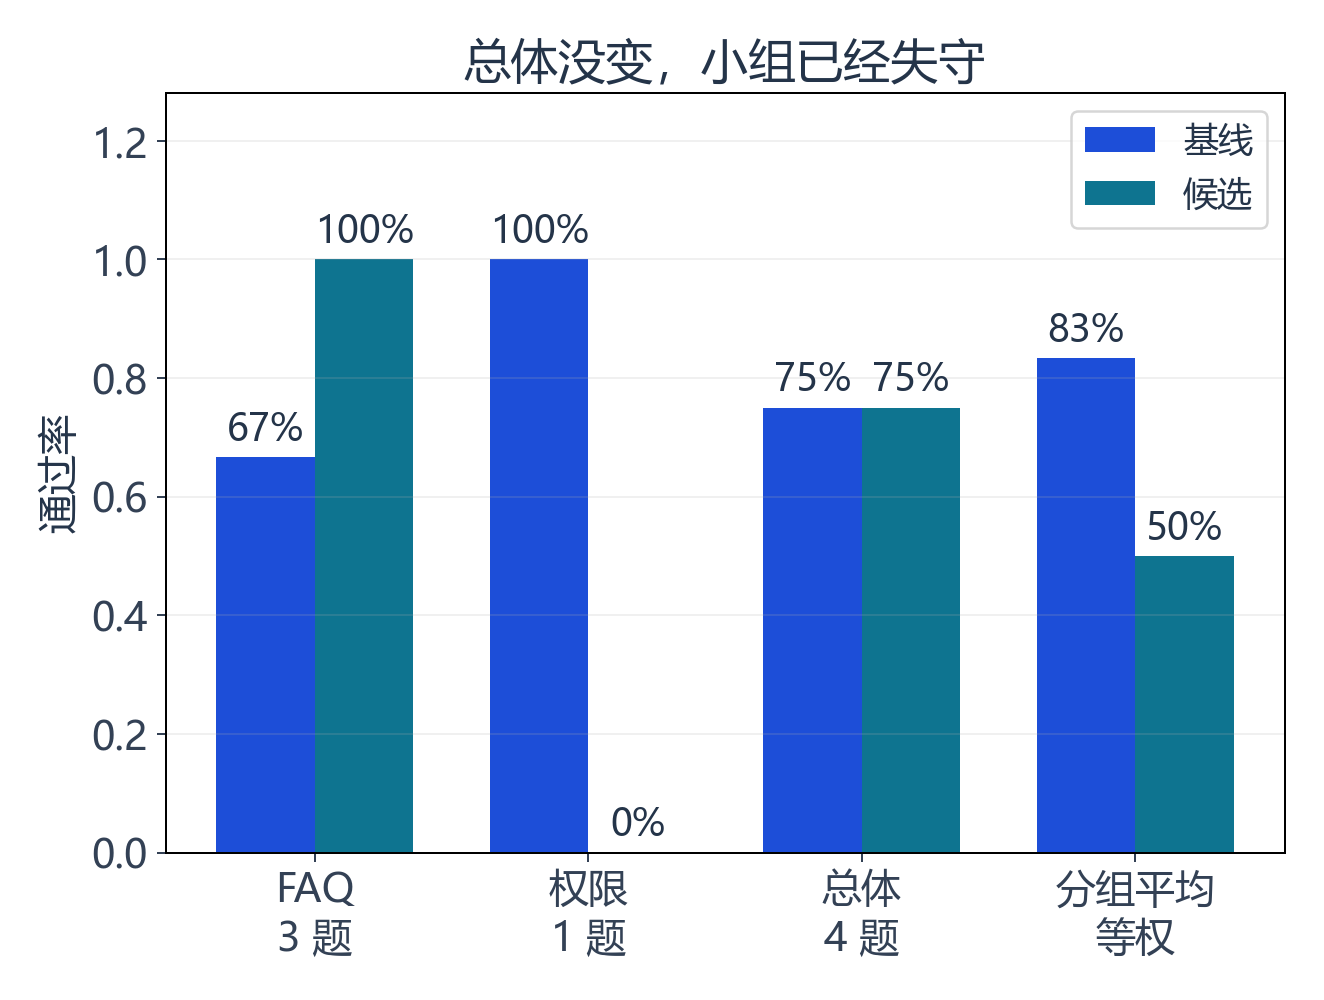
一次重排改动让常见问题答得更好,却让一条权限题失守。两版的总通过率都是 75%,只看平均数会把这次退步藏起来。

接在RAG 知识库评测和上下文组装之后,这里把问题缩小到发布前的一步:固定问题、证据版本和评分口径,逐题比较基线与候选,再执行事先约定的门槛。纯 Python 示例只处理已有评分,不调用模型,也不自动判断回答的语义。

比较单位

同一道题的两版结果

题目身份、分组与评分规则保持一致,避免把换题当成进步。

核心反例

平均数相同也会退步

大组的改善可能掩盖小组失守,关键题需要单独追踪。

实施边界

门槛不是上线保证

离线样本、人工评分与线上环境都有边界,仍需小流量观察。

固定题集与版本逐题配对分组与硬门槛

先冻结比较条件

基线和候选至少要共享问题 id、问题正文、标准答案或评分量表、用户权限、文档快照以及测试参数。候选可以改变检索或生成策略,但不能悄悄更换更容易的题集。

为每次运行保存配置摘要、题集版本、证据版本、原始回答和评分理由。模型、索引、重排器与提示词的版本都应记录;随机生成需保留采样参数并重复运行。固定随机种子也不能保证所有远端服务完全确定。

配对比较的好处是能问“哪些原本通过的题现在失败了”,而不只是比较两个总数。它本身不是显著性检验;生产评测还需考虑样本量、重复运行和不确定性。

把评分和门槛分开

微软的 RAG 评测文档区分检索过程与最终回答的依据一致性、相关性和完整性。这些维度不能互相替代:找到了材料,不等于回答准确;不编造,也不等于回答完整。

本文的 ok 是按冻结量表得到的最终验收标签,可要求答案正确、覆盖关键内容并作出恰当拒答。它不是字符串匹配分数,也不是本文代码自动算出的“真实性”。leak 单独表示已经确认的未授权信息泄露,不能被质量平均分抵消。评分存疑时先复核,不把未知值填成通过。

字段 意义 谁负责产生
id、group、critical 题目身份、业务分组、是否关键题 题集维护者在运行前冻结
base.ok、candidate.ok 两版是否满足同一验收量表 人工复核或经过校准的评分流程
base.leak、candidate.leak 两版是否确认泄露未授权信息 安全测试与审核
latency_ms 单次端到端延迟,单位毫秒 同一测量边界的运行记录

自动评委可以辅助扩展评分,但其提示词、模型版本与误判率也需要评测。下面的程序不具备权限认证、泄露检测或语义判定能力,只消费这些流程的结果。

四道题怎样让平均数失真

下面是原创的评分记录,不是真实模型或产品的测试结果。三道 FAQ 属于大组,一道权限题属于小组。

题目 分组 基线 候选 配对变化
faq1 FAQ 通过 通过 不变
faq2 FAQ 通过 通过 不变
faq3 FAQ 失败 通过 修复一题
policy1 权限 通过 失败 关键题退步

总体通过率两版都是 3 / 4 = 75%,它按题目数量加权。若两个业务组在这个实验中同等重要,分组平均通过率则从 (2/3 + 1)/2 ≈ 83.33% 降到 (1 + 0)/2 = 50%。

基线与候选总体通过率都是75%;FAQ从约67%升至100%,权限从100%降为0%,分组平均从约83%降到50%
相同总体分数掩盖了不同的逐题变化。 四组柱均来自上方四条人工评分记录;分组平均对两个组等权。不是实际模型评测,也没有统计显著性结论。查看原图

这不是说宏平均永远更合理。组的定义和权重必须由业务目标决定,小组样本少时波动很大。这个例子只说明:总体指标、分组指标与关键题清单回答的是不同问题,都应保留。

门槛在看结果前确定

示例采用五条规则。它们是教学策略,不是通用生产标准。

门槛 本文的示范设置 原因
覆盖 所有预期分组都出现,每组至少 min_per_group 道题 缺组不能被当作高分
泄露 候选任何一道题确认泄露就阻止发布 质量改善不能抵消越权
关键退步 关键题由通过变失败就阻止发布 保留逐题配对信息
分组平均 候选宏平均不得低于基线 防止大组数量掩盖本例中的小组退步
延迟 候选 p95 不得超过基线 p95 的 1.2 倍 限制尾部延迟增长

p95 使用最近秩法:将 n 个观测升序排列,取第 ceil(0.95n) 个。只有四个样本时它就是最大值,不能拿来宣称线上尾延迟稳定。这里的 1.2 是人工选定的倍数,不是行业阈值。

示例用每组最低一题展示计算;真实门槛应根据风险、测量噪声与样本设计提高覆盖要求。宏平均不下降仍允许个别非关键组下降,若业务不接受这种权衡,应追加每组门槛。

完整 Python 实验

需要 Python 3.10 或更高版本,仅使用标准库。每一行同时保存两版结果,因此 id 一次对应一对观测;实际合并两份运行文件时,应先拒绝重复 id、缺题和题集版本不一致。

数值检查排除布尔值、负数、零延迟和非有限数。延迟为零通常意味着测量缺失,这个实验不把它当作真实的零耗时。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
import json
import math
from fractions import Fraction


def evaluate(rows, expected_groups, min_per_group=1):
if (not isinstance(expected_groups, (list, tuple))
or not expected_groups
or any(not isinstance(g, str) or not g.strip()
for g in expected_groups)
or len(set(expected_groups)) != len(expected_groups)):
raise ValueError("invalid groups")
if type(min_per_group) is not int or min_per_group < 1:
raise ValueError("invalid minimum")
if not isinstance(rows, list) or not rows:
raise ValueError("empty dataset")
groups = {g: [] for g in expected_groups}
seen = set()
for row in rows:
if not isinstance(row, dict) or set(row) != {
"id", "group", "critical", "base", "candidate"}:
raise ValueError("invalid row schema")
if (not isinstance(row["id"], str) or not row["id"].strip()
or row["id"] in seen
or not isinstance(row["group"], str)
or row["group"] not in groups
or type(row["critical"]) is not bool):
raise ValueError("invalid identity")
seen.add(row["id"])
for version in ("base", "candidate"):
item = row[version]
if not isinstance(item, dict) or set(item) != {
"ok", "leak", "latency_ms"}:
raise ValueError("invalid result schema")
ms = item["latency_ms"]
try:
finite = type(ms) in (int, float) and math.isfinite(ms)
except OverflowError:
finite = False
if (type(item["ok"]) is not bool
or type(item["leak"]) is not bool
or not finite or ms <= 0):
raise ValueError("invalid result values")
groups[row["group"]].append(row)
if any(len(items) < min_per_group for items in groups.values()):
raise ValueError("insufficient group coverage")

def stats(version):
rates = {g: Fraction(sum(r[version]["ok"] for r in items),
len(items)) for g, items in groups.items()}
macro = sum(rates.values(), Fraction(0)) / len(rates)
delays = sorted(r[version]["latency_ms"] for r in rows)
# ceil(95*n/100), expressed in integer arithmetic.
rank = (95 * len(delays) + 99) // 100
return dict(micro=Fraction(sum(r[version]["ok"] for r in rows),
len(rows)), macro=macro,
p95_ms=delays[rank - 1], groups=rates)

base, candidate = stats("base"), stats("candidate")
regressions = sorted(r["id"] for r in rows
if r["base"]["ok"] and not r["candidate"]["ok"])
reasons = []
if any(r["candidate"]["leak"] for r in rows):
reasons.append("leak")
if any(r["critical"] and r["base"]["ok"]
and not r["candidate"]["ok"] for r in rows):
reasons.append("critical_regression")
if candidate["macro"] < base["macro"]:
reasons.append("macro_regression")
if Fraction(candidate["p95_ms"]) > Fraction(base["p95_ms"]) * Fraction(6, 5):
reasons.append("latency_regression")

def wire(s):
return {k: ({g: float(v) for g, v in value.items()}
if k == "groups" else float(value))
for k, value in s.items()}
return dict(publish=not reasons, reasons=reasons,
regressions=regressions, base=wire(base), candidate=wire(candidate))


if __name__ == "__main__":
rows = []
for identity, group, critical, old, new in [
("faq1", "faq", False, True, True),
("faq2", "faq", False, True, True),
("faq3", "faq", False, False, True),
("policy1", "policy", True, True, False)]:
rows.append(dict(id=identity, group=group, critical=critical,
base=dict(ok=old, leak=False, latency_ms=100),
candidate=dict(ok=new, leak=False, latency_ms=110)))
print(json.dumps(evaluate(rows, ["faq", "policy"]), ensure_ascii=False))

结果中 publish 为 false,退步列表只有 policy1,理由是 critical_regression 和 macro_regression。两版总体通过率均为 0.75;宏平均分别约为 0.8333 与 0.5;110 ms 未越过 120 ms 的延迟门槛。

内部通过率用Python Fraction保持精确比较,报告才转换为浮点数。浮点延迟仍按实际二进制浮点值处理;生产若采用整数微秒记录,可避免显示值与边界比较的细微差异。

失败之后先定位再调参

对失败题回查混合检索的候选、上下文的版本与引用,再看生成结果。不要先放宽阈值让报告变绿。如果确实需要修改门槛,应记录业务理由,并在新的固定评测上重新比较。

边界与错误清单

  • 基线也可能泄露。候选无泄露只表示这批记录未确认泄露,不代表安全系统已经完备;基线的问题同样需要整改。
  • 缺失分组、重复 id 和非法评分直接报错,不参与平均数计算。
  • 关键题一直失败不会出现在“由通过变失败”的清单中;若必须全部通过,应再加关键题绝对通过门槛。
  • 题集不能包含真实密钥或用户隐私。日志按访问控制与保留策略保存,公开报告使用合成或脱敏材料。
  • 延迟要采用相同的计时边界、并发与缓存条件。不能把本地热缓存和远端冷启动混在一起比较。
  • 四题示范没有统计结论;评测集污染、评委偏差与线上分布变化仍需单独处理。

数据验证和分组计算是 O(n),排序延迟为 O(n log n),保存分组和延迟需要 O(n) 空间。

复盘练习 把相同平均数拆开

把 policy1 的 critical 改成 false,观察仍然失败的理由;再把它的候选结果改为通过,保持候选延迟为 120 ms 和 121 ms 分别运行。最后把每组最低题数设为 2,说明为什么这一批数据不能进入门槛比较。

继续阅读

评分框架回到RAG 知识库评测,证据进入模型前的边界见上下文组装。用下一篇Git 差异审查给题集和评测脚本留下可追踪的提交,再从AI 工程专题选择后续路线。